Sincronização labial em tempo real, offline e multiplataforma para MetaHuman e personagens personalizados. Suporte universal a idiomas - funciona com qualquer idioma falado, em qualquer plataforma. Adequado para jogos, quiosques interativos, produção virtual, assistentes digitais, simulações de treinamento e muito mais.
Escolha o modelo que atende aos requisitos do seu projeto - de ampla compatibilidade de plataformas a animação facial com qualidade cinematográfica e expressão emocional.
Otimizado para desempenho em tempo real em todas as plataformas compatíveis. Funciona com MetaHumans e qualquer personagem com morph targets.
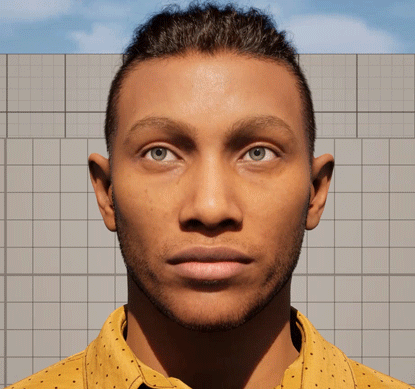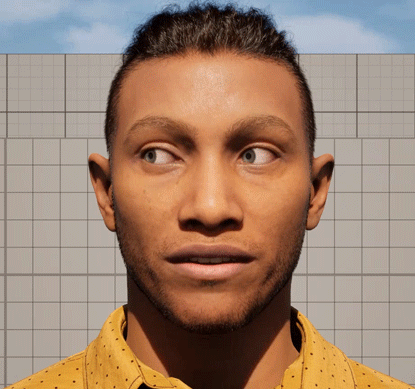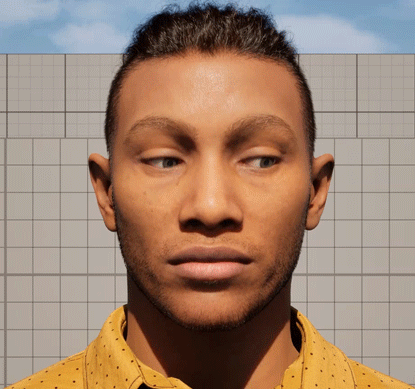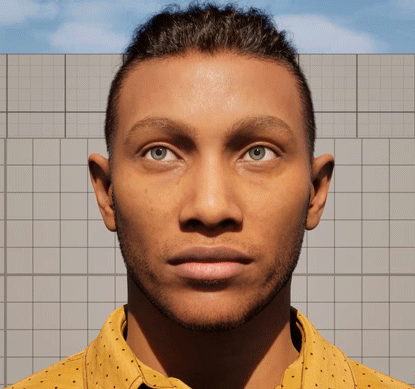
81 controles faciais para movimentos de boca naturais e de alta qualidade, para MetaHuman e personagens compatíveis com ARKit. Disponível em duas variantes: a Realista padrão e a Mood-Enabled, para expressão emocional.
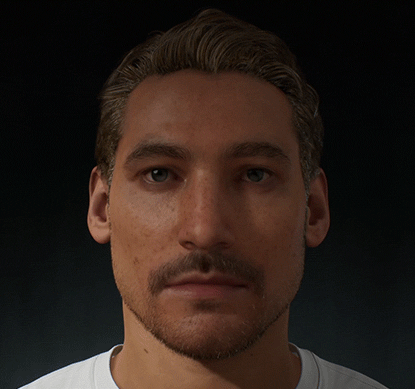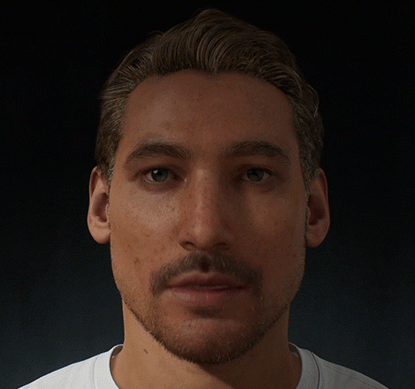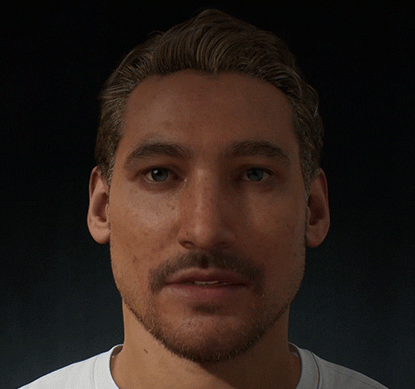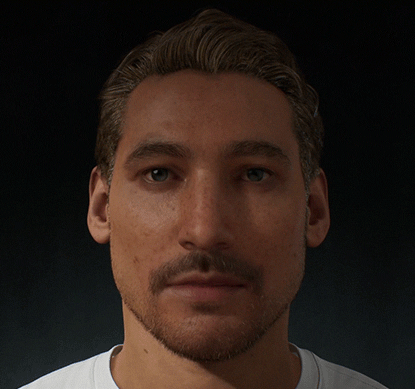
Variante Mood-Enabled
O plugin analisa fonemas de áudio bruto diretamente - sem necessidade de transcrição de texto - tornando-o totalmente independente de idioma e adequado para qualquer idioma falado.
Microfone, TTS ou arquivos de áudio - qualquer fonte de dados de áudio
Processamento de áudio independente de idioma, no dispositivo
Visemas ou controles faciais gerados com contexto de humor opcional
Aplicado ao personagem com transições de blending suaves
Qualquer fonte de áudio que forneça dados PCM é suportada.
Lip sync em tempo real a partir da captura de microfone ao vivo usando a onda sonora capturável do Runtime Audio Importer.
Compatível com TTS local offline e serviços externos, incluindo ElevenLabs, OpenAI, Azure, Google Cloud e muito mais.
Processe arquivos de áudio pré-gravados, fontes de streaming ou qualquer provedor PCM personalizado.
Apesar do nome, o plugin funciona muito além dos MetaHumans.
Todos os três modelos suportam MetaHumans, com saída de controle facial direto para os modelos Realistic e Mood-Enabled.
O modelo Standard oferece suporte a Daz Genesis 8/9, Reallusion CC3/CC4/CC5, Mixamo e muito mais por meio de mapeamento flexível de visemes. Os modelos Realistic e Mood-Enabled também oferecem suporte a esses por meio do ARKit, por exemplo, CC3/CC4/CC5 convertidos para ARKit na exportação.
Qualquer personagem com morph targets pode ser configurado. Oferece suporte aos sistemas de fonemas FACS, Apple ARKit, Preston Blair e 3ds Max.
Modelo Standard - Exemplos de Personagens Personalizados
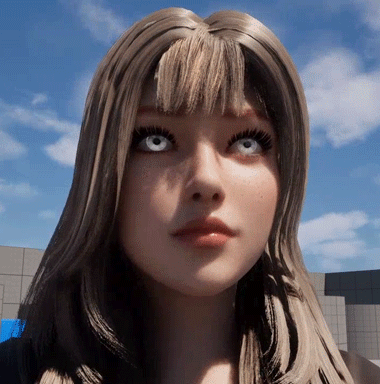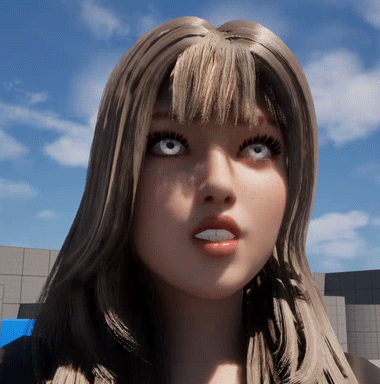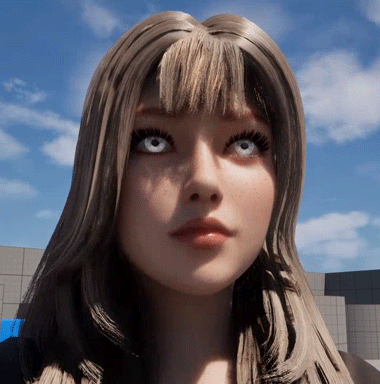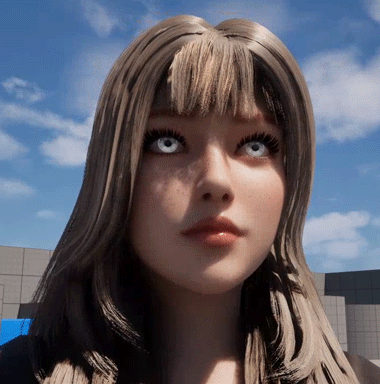
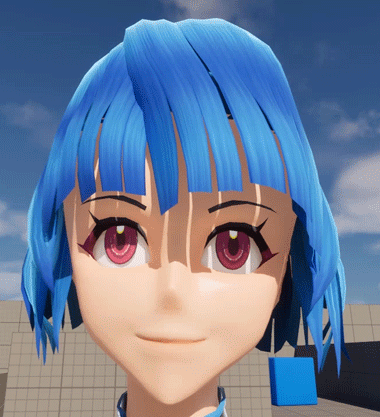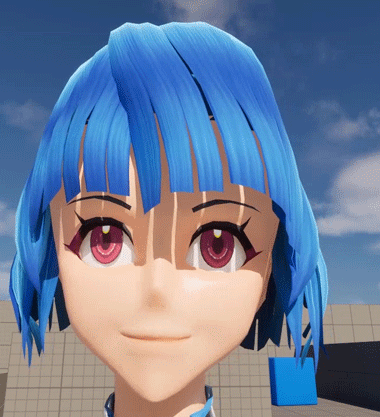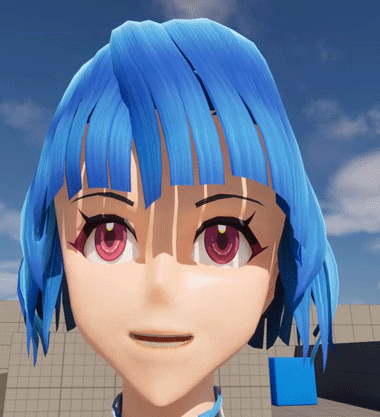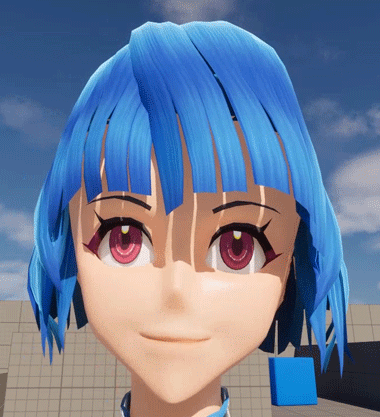
O plugin processa fonemas de áudio brutos diretamente, em vez de depender de transcrição de texto, o que o torna inerentemente independente de idioma.
Inglês, Espanhol, Francês, Alemão, Japonês, Chinês, Coreano, Russo, Árabe, Hindi, Português - e qualquer outro idioma falado.
Referência rápida para suporte a plataformas e capacidades dos modelos.
| Capacidade | Standard | Realistic | Mood-Enabled |
|---|---|---|---|
| Controles de animação | 14 visemes | 81 controles | 81 + 12 humores |
| MetaHuman | |||
| Personagens personalizados | Via ARKit | Via ARKit | |
| Detecção de riso | |||
| Windows | |||
| Mac / Linux / iOS | |||
| Android / Quest |
Demos, tutoriais e walkthroughs cobrindo todos os modelos, fontes de áudio e fluxos de trabalho de integração. Todo o conteúdo é compatível com Unreal Engine 5.0 até 5.8.
Fluxo de trabalho completo: reconhecimento de fala, chatbot de IA, TTS e sincronização labial em tempo real.
Como adicionar seu próprio personagem MetaHuman ao projeto de demonstração.
Configuração completa de Animation Blueprint para personagens ARKit, com exemplos de arquivo de áudio e streaming da ElevenLabs.
Piscar automático e olhar dinâmico que segue a câmera do jogador ou qualquer alvo em movimento, configurável no Face Animation Blueprint.
Voz, sincronização labial e animação facial em execução ao vivo no Unreal Engine 5.
Demonstração do modelo Realistic com microfone, TTS local, ElevenLabs e vários idiomas.
Configure uma sincronização labial realista reproduzindo um arquivo de áudio no seu MetaHuman, também funciona com buffers de áudio.
Controle o lip sync em tempo real a partir de uma fonte de áudio em streaming via WebSocket, com o áudio importado e processado chunk a chunk.
Text-to-speech offline com lip sync de alta qualidade sensível a emoções, 12 humores com intensidade ajustável.
Modelo realista com ElevenLabs e OpenAI para uma saída de qualidade premium.
Lip sync em tempo real a partir da entrada do microfone usando o modelo Realistic.
Lip sync totalmente offline com TTS local, sem necessidade de internet.
O Runtime MetaHuman Lip Sync integra-se ao amplo conjunto de plugins da Georgy Dev para construir pipelines completos de personagens interativos.
Importe, transmita e capture áudio em tempo de execução para conduzir animações de lip sync a partir de qualquer fonte.
Saiba maisAdicione reconhecimento de fala para personagens interativos que respondem a comandos de voz.
Saiba maisSíntese de fala offline com mais de 2800 vozes, totalmente compatível com todos os modelos de lip sync.
Saiba maisConversas orientadas por AI com respostas em linguagem natural e animação labial sincronizada.
Saiba maisGere diálogos com LLMs no dispositivo de forma offline e, em seguida, conduza o lip sync a partir da fala sintetizada para interações de personagens totalmente offline.
Saiba maisA documentação abrangente cobre todos os três modelos - desde a configuração inicial até a configuração avançada de personagens, animação emocional e mapeamento personalizado de visemes.
Guias passo a passo para todos os modelos, integração com MetaHuman e personagens personalizados
Comunidade ativa no Discord com suporte de desenvolvedores
Integração sob medida ou desenvolvimento de recursos - [email protected]
Disponível no Fab para UE 5.0 – 5.8. Inclui todos os três modelos, documentação completa e projetos de demonstração.
