针对所有受支持平台上的实时性能进行了优化。可与 MetaHuman 以及任何具有变形目标的角色配合使用。
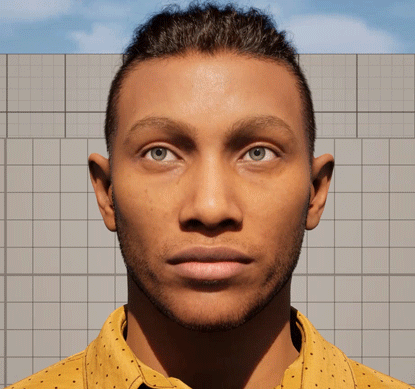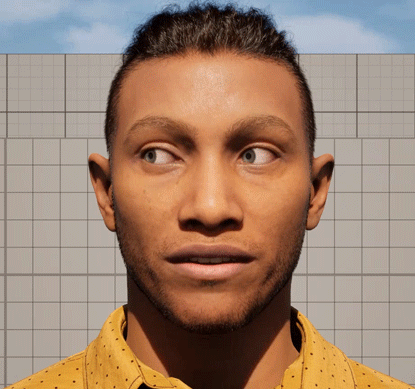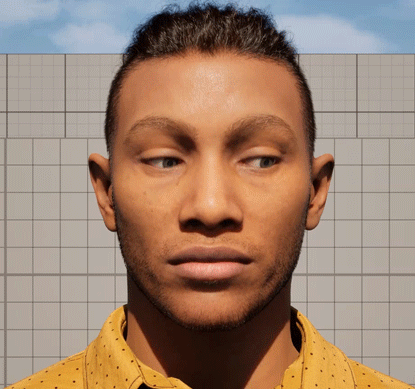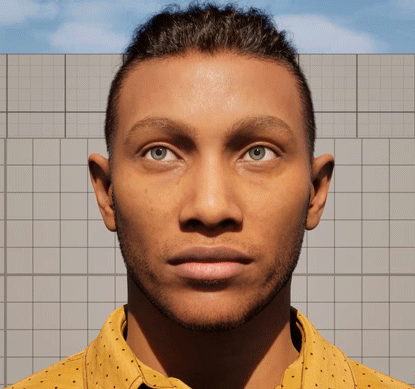
81 个面部控制项,为 MetaHuman 和兼容 ARKit 的角色带来自然、高质量的嘴部动作。 提供两种变体:标准写实版和用于情感表达的情绪模式版。
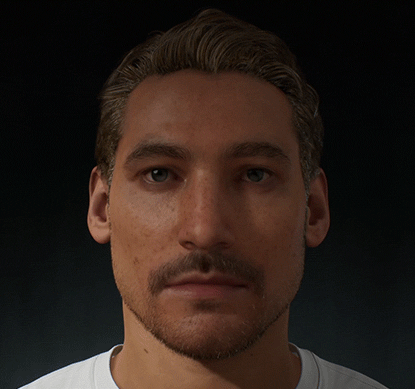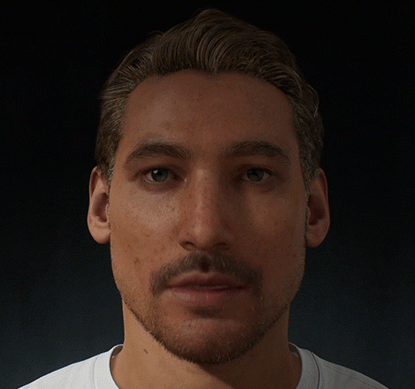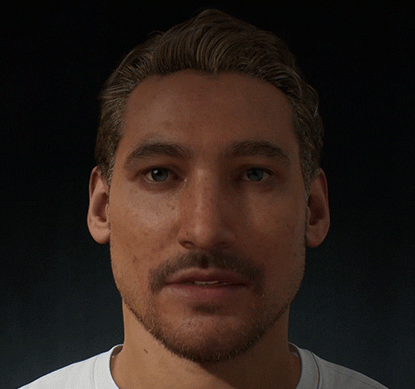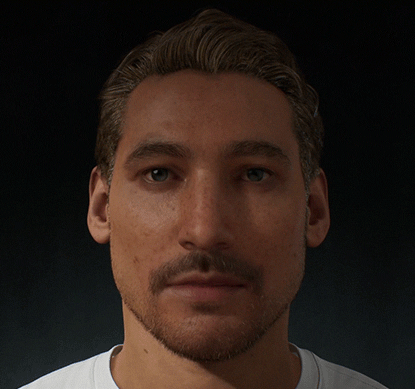
Mood-Enabled 变体
该插件直接分析原始音频音素——无需文本转录——因此完全与语言无关,适用于任何口语。
麦克风、TTS 或音频文件——任何音频数据源
与语言无关的设备端音频处理
视位或面部控制器,并可选择附带情绪上下文生成
应用于角色,并带有平滑的混合过渡
支持任何提供 PCM 数据的音频源。
使用 Runtime Audio Importer 的可捕获声波,从实时麦克风采集实现实时口型同步。
兼容本地离线 TTS 以及 ElevenLabs、OpenAI、Azure、Google Cloud 等外部服务。
处理预先录制的音频文件、流媒体源或任何自定义 PCM 提供程序。
尽管名称如此,该插件的适用范围远不止 MetaHuman。
全部三种模型都支持 MetaHuman,其中 Realistic 和 Mood-Enabled 可输出直接的面部控制。
Standard 模型通过灵活的视位映射支持 Daz Genesis 8/9、Reallusion CC3/CC4/CC5、Mixamo 等。Realistic 和 Mood-Enabled 也可通过 ARKit 支持这些,例如在导出时将 CC3/CC4/CC5 转换为 ARKit。
任何带有变形目标的角色均可配置。支持 FACS、Apple ARKit、Preston Blair 以及 3ds Max 音素系统。
Standard 模型 - 自定义角色示例
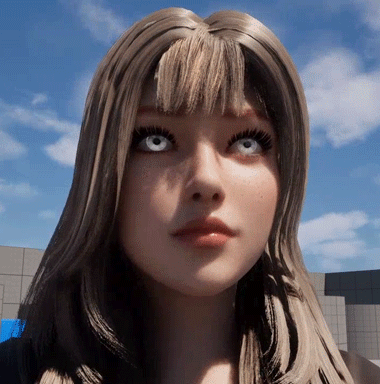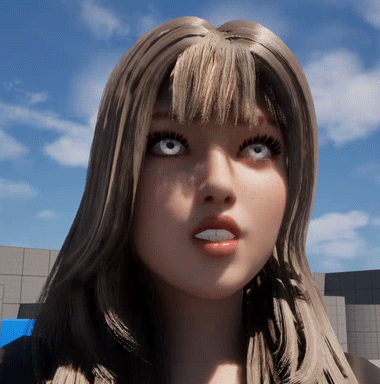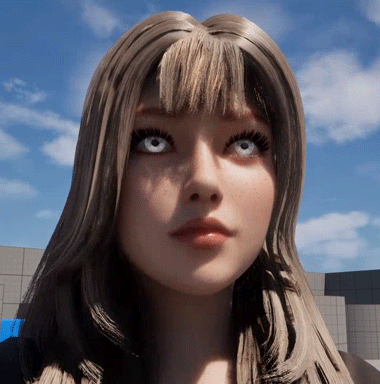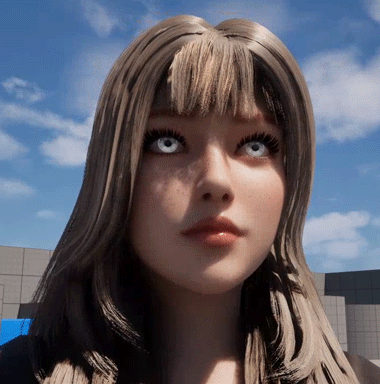
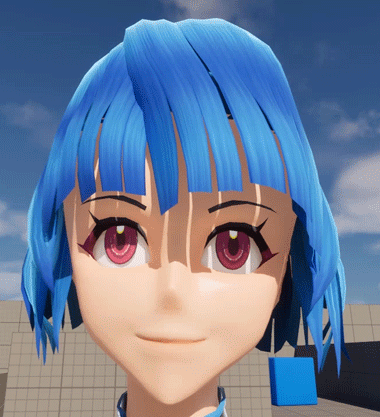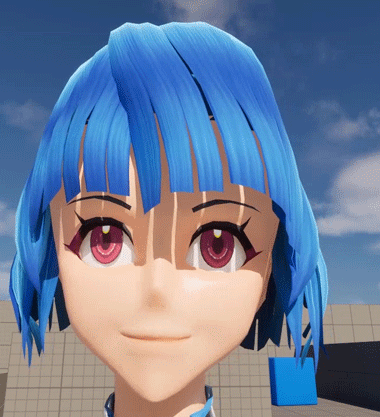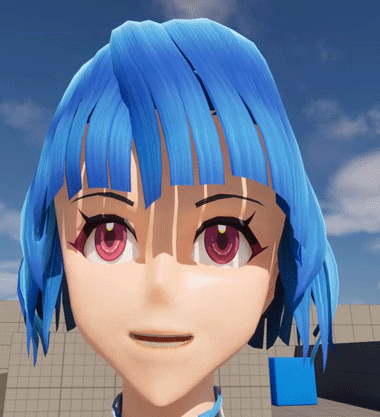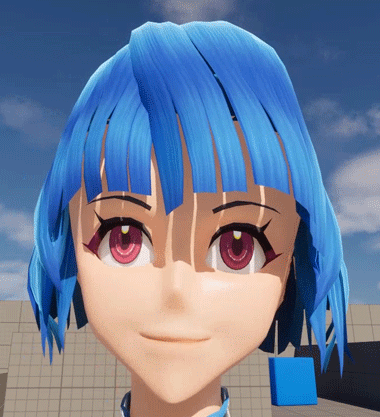
该插件直接处理原始音频音素,而不依赖文本转录, 因此天生与语言无关。
英语、西班牙语、法语、德语、日语、中文、韩语、俄语、阿拉伯语、印地语、 葡萄牙语——以及任何其他口语。
平台支持与模型功能的快速参考。
| 功能 | Standard | Realistic | Mood-Enabled |
|---|---|---|---|
| 动画控制项 | 14 个视位 | 81 个控制项 | 81 + 12 种情绪 |
| MetaHuman | |||
| 自定义角色 | 通过 ARKit | 通过 ARKit | |
| 笑声检测 | |||
| Windows | |||
| Mac / Linux / iOS | |||
| Android / Quest |
演示、教程和逐步讲解,涵盖所有模型、音频源和 集成工作流程。所有内容均兼容 Unreal Engine 5.0 至 5.8。
完整工作流程:语音识别、AI 聊天机器人、TTS 和实时 唇形同步。
如何将自己的 MetaHuman 角色添加到演示项目。
为 ARKit 角色提供完整的动画蓝图设置,包含音频 文件和 ElevenLabs 流式传输示例。
自动眨眼和动态视线,可跟随玩家摄像机 或任意 移动目标,可在面部动画蓝图中配置。
语音、唇形同步和面部动画在 Unreal Engine 5 中实时运行。
展示 Realistic 模型在麦克风、本地 TTS、 ElevenLabs 和 多种语言下的效果。
通过在你的 MetaHuman 上播放音频文件来设置逼真的唇形同步,也 适用于音频缓冲区。
通过 WebSocket 从流式音频源驱动实时唇形同步,音频以逐个数据块的方式导入和处理。
离线文本转语音,具备情感感知的高质量唇形同步,12 种情绪,强度可调。
搭配 ElevenLabs 和 OpenAI 的 Realistic 模型,实现高品质输出。
使用 Realistic 模型,从麦克风输入实现实时唇形同步。
使用本地 TTS 实现完全离线的唇形同步,无需互联网。
Runtime MetaHuman Lip Sync 可与更广泛的 Georgy Dev 插件套件集成,构建完整的交互式角色工作流。
全面的文档涵盖全部三种模型——从初始设置到高级角色配置、情感动画以及自定义视位映射。
适用于所有模型、MetaHuman 集成和自定义角色的分步指南
活跃的 Discord 社区,提供开发者支持
量身定制的集成或功能开发 - [email protected]