Lip sync en tiempo real, sin conexión y multiplataforma para MetaHuman y personajes personalizados. Compatibilidad universal de idiomas: funciona con cualquier idioma hablado, en cualquier plataforma. Adecuado para juegos, kioscos interactivos, producción virtual, asistentes digitales, simulaciones de formación y mucho más.
Elige el modelo que se adapte a los requisitos de tu proyecto, desde una amplia compatibilidad de plataformas hasta animación facial de calidad cinematográfica con expresión emocional.
Optimizado para el rendimiento en tiempo real en todas las plataformas compatibles. Funciona con MetaHumans y cualquier personaje con morph targets.
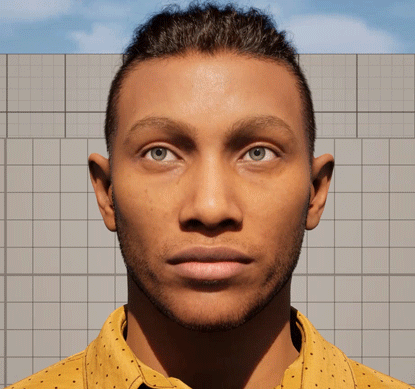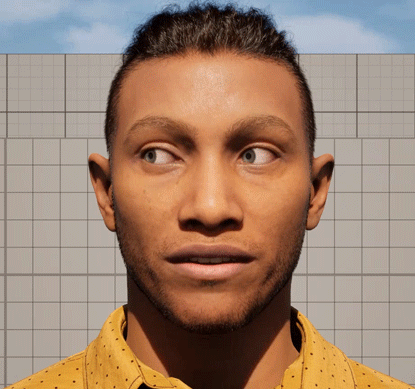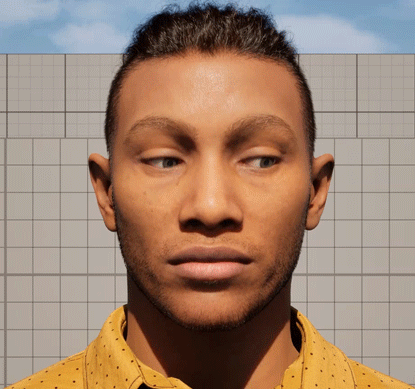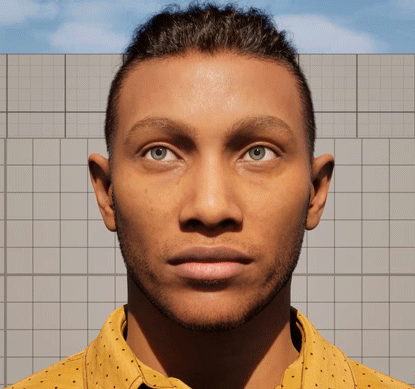
81 controles faciales para un movimiento de la boca natural y de alta calidad, para MetaHuman y personajes compatibles con ARKit. Disponible en dos variantes: Realista estándar y con estados de ánimo para expresión emocional.
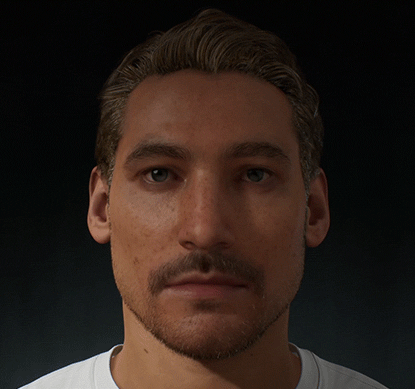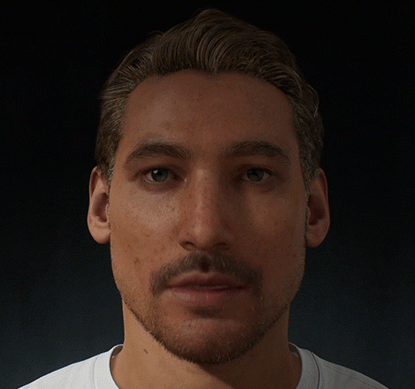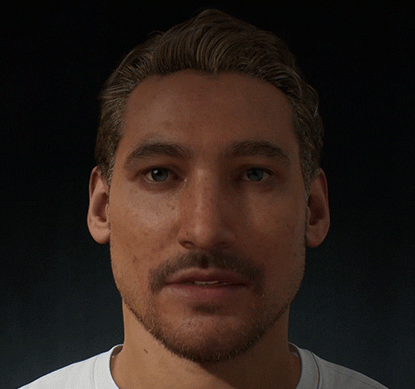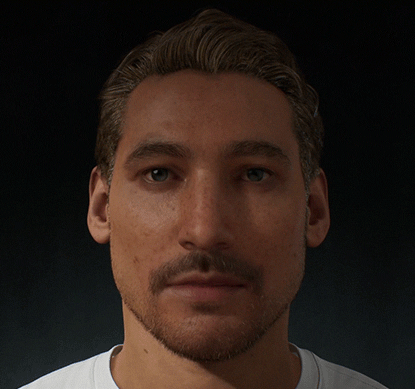
Variante con estados de ánimo
El plugin analiza directamente los fonemas de audio sin procesar, sin necesidad de transcripción de texto, lo que lo hace totalmente independiente del idioma y apto para cualquier idioma hablado.
Micrófono, TTS o archivos de audio - cualquier fuente de datos de audio
Procesamiento de audio independiente del idioma, en el dispositivo
Visemas o controles faciales generados con contexto de estado de ánimo opcional
Aplicado al personaje con transiciones de mezcla suaves
Se admite cualquier fuente de audio que proporcione datos PCM.
Sincronización labial en tiempo real a partir de la captura de micrófono en vivo usando la onda de sonido capturable de Runtime Audio Importer.
Compatible con TTS local sin conexión y servicios externos como ElevenLabs, OpenAI, Azure, Google Cloud y más.
Procesa archivos de audio pregrabados, fuentes de transmisión o cualquier proveedor de PCM personalizado.
A pesar del nombre, el plugin funciona bien más allá de MetaHumans.
Los tres modelos admiten MetaHumans, con salida directa de control facial para Realista y con estados de ánimo.
El modelo Standard admite Daz Genesis 8/9, Reallusion CC3/CC4/CC5, Mixamo y más mediante un mapeo flexible de visemas. Realistic y Mood-Enabled también los admiten mediante ARKit, por ejemplo, CC3/CC4/CC5 convertidos a ARKit al exportar.
Se puede configurar cualquier personaje con objetivos de morph. Compatible con FACS, Apple ARKit, Preston Blair y sistemas de fonemas de 3ds Max.
Modelo Standard: ejemplos de personajes personalizados
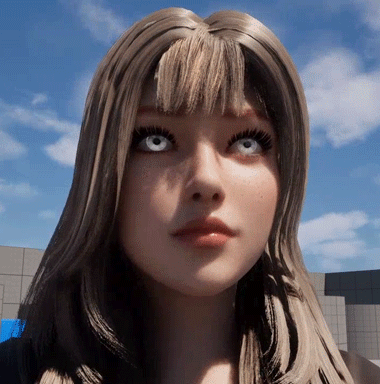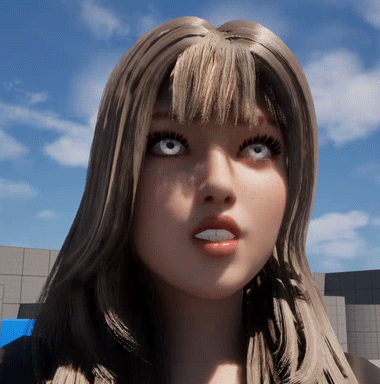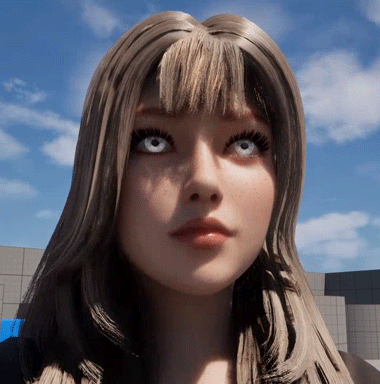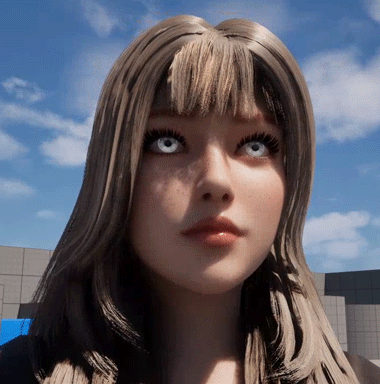
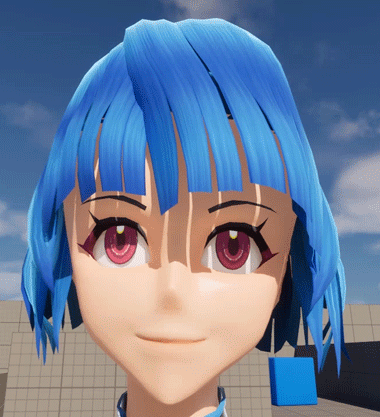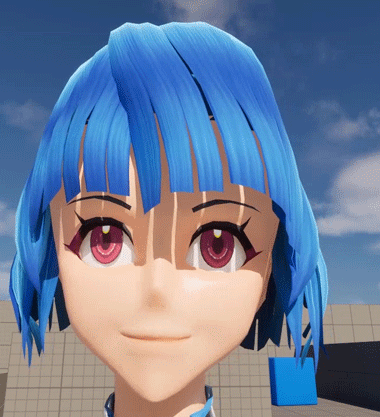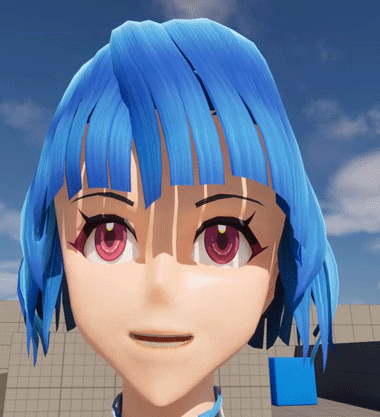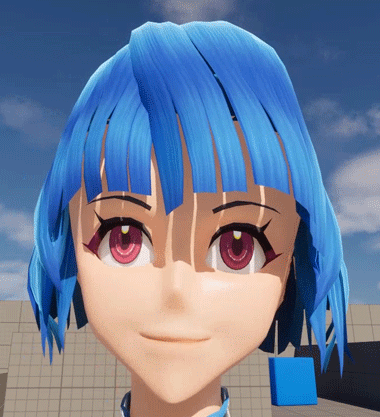
El plugin procesa directamente los fonemas de audio sin procesar en lugar de depender de la transcripción de texto, lo que lo hace inherentemente independiente del idioma.
Inglés, español, francés, alemán, japonés, chino, coreano, ruso, árabe, hindi, portugués, y cualquier otro idioma hablado.
Referencia rápida sobre la compatibilidad de plataformas y las capacidades de los modelos.
| Capacidad | Standard | Realistic | Mood-Enabled |
|---|---|---|---|
| Controles de animación | 14 visemas | 81 controles | 81 + 12 estados de ánimo |
| MetaHuman | |||
| Personajes personalizados | Mediante ARKit | Mediante ARKit | |
| Detección de risa | |||
| Windows | |||
| Mac / Linux / iOS | |||
| Android / Quest |
Demos, tutoriales y guías paso a paso que abarcan todos los modelos, fuentes de audio y flujos de trabajo de integración. Todo el contenido es compatible con Unreal Engine 5.0 hasta 5.8.
Flujo de trabajo completo: reconocimiento de voz, chatbot de AI, TTS y sincronización labial en tiempo real.
Cómo añadir tu propio personaje MetaHuman al proyecto de demostración.
Configuración completa de Animation Blueprint para personajes ARKit, con archivo de audio y ejemplos de streaming de ElevenLabs.
Parpadeo automático y mirada dinámica que sigue la cámara del jugador o cualquier objetivo en movimiento, configurable en el Animation Blueprint facial.
Voz, sincronización labial y animación facial en vivo en Unreal Engine 5.
Muestra del modelo Realistic con micrófono, TTS local, ElevenLabs y varios idiomas.
Configura una sincronización labial realista reproduciendo un archivo de audio en tu MetaHuman, también funciona con búferes de audio.
Controla la sincronización labial en tiempo real desde una fuente de audio en streaming a través de WebSocket, con el audio importado y procesado fragmento a fragmento.
Texto a voz offline con sincronización labial de alta calidad y sensible a las emociones, 12 estados de ánimo con intensidad ajustable.
Modelo Realista con ElevenLabs y OpenAI para una salida de calidad premium.
Sincronización labial en tiempo real desde la entrada de micrófono utilizando el modelo Realista.
Sincronización labial totalmente offline con TTS local, no se necesita internet.
Runtime MetaHuman Lip Sync se integra con la amplia suite de plugins de Georgy Dev para construir pipelines completos de personajes interactivos.
Importa, transmite y captura audio en tiempo de ejecución para controlar animaciones de sincronización labial desde cualquier fuente.
Más informaciónAñade reconocimiento de voz para personajes interactivos que responden a comandos de voz.
Más informaciónSíntesis de voz offline con más de 2800 voces, totalmente compatible con todos los modelos de sincronización labial.
Más informaciónConversaciones impulsadas por IA con respuestas en lenguaje natural y animación labial sincronizada.
Más informaciónGenera diálogos con LLM en el dispositivo offline, luego controla la sincronización labial a partir del habla sintetizada para interacciones de personajes totalmente offline.
Más informaciónLa documentación completa cubre los tres modelos: desde la configuración inicial hasta la configuración avanzada de personajes, animación emocional y mapeo de visemas personalizado.
Guías paso a paso para todos los modelos, integración con MetaHuman y personajes personalizados
Comunidad activa en Discord con soporte para desarrolladores
Integración o desarrollo de funciones a medida - [email protected]
Disponible en Fab para UE 5.0 – 5.8. Incluye los tres modelos, documentación completa y proyectos de demostración.
