MetaHuman とカスタムキャラクター向けの、リアルタイム、オフライン、クロスプラットフォーム対応のリップシンク。 あらゆる言語に対応 - どのプラットフォームでも、あらゆる話し言葉で動作します。 ゲーム、インタラクティブキオスク、バーチャルプロダクション、デジタルアシスタント、トレーニングシミュレーションなどに最適です。
サポートされているすべてのプラットフォームでリアルタイムパフォーマンスに最適化。MetaHuman および モーフターゲットを持つあらゆるキャラクターで動作します。
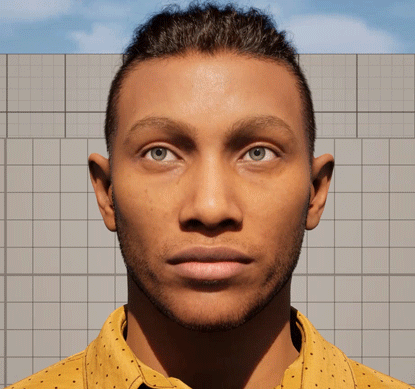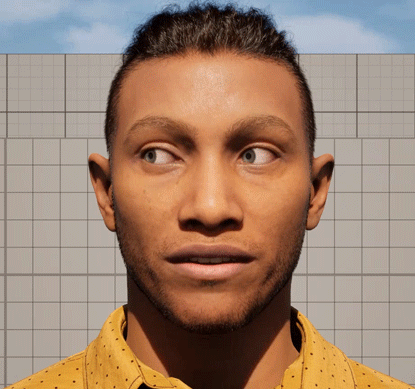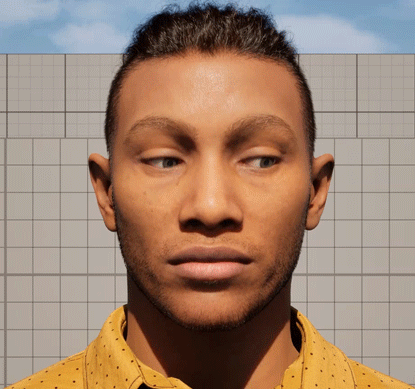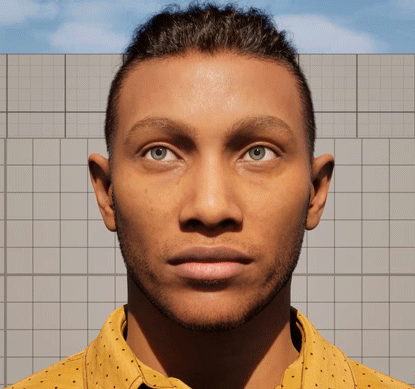
MetaHuman および ARKit 互換キャラクター向けの、自然で高品質な口の動きを実現する 81 のフェイシャルコントロール。 スタンダードなリアリスティックと、感情表現のためのムード対応の 2 つのバリアントがあります。
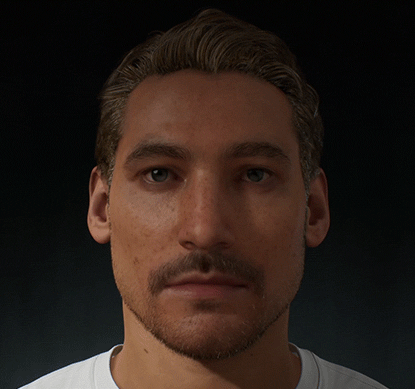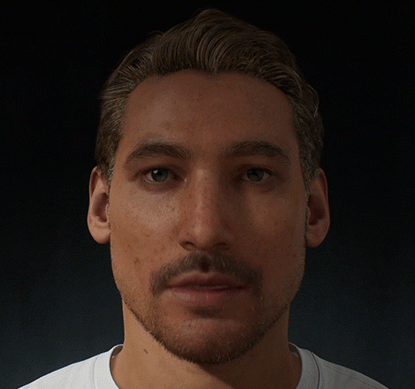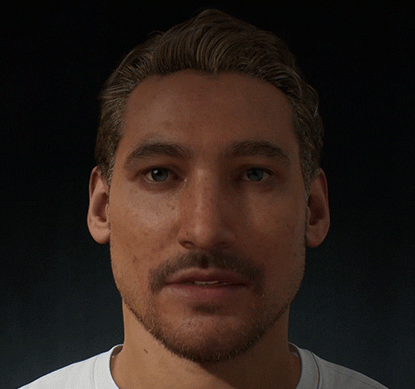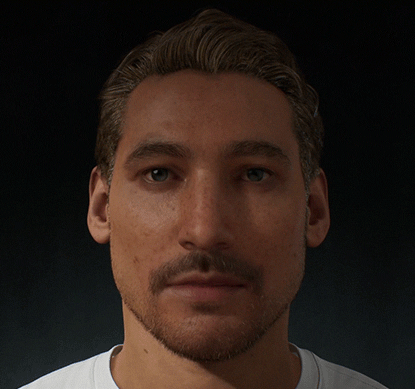
Mood-Enabledバリアント
このプラグインは生のオーディオ音素を直接分析します - テキストの文字起こしは不要 - そのため完全に言語非依存で、あらゆる話し言葉に適しています。
マイク、TTS、またはオーディオファイル - あらゆるオーディオデータソース
言語非依存のオーディオ処理、オンデバイス
オプションのムードコンテキスト付きで生成されるビゼームまたは顔コントロール
スムーズなブレンド遷移でキャラクターに適用
PCMデータを提供するあらゆるオーディオソースをサポートします。
Runtime Audio Importerのキャプチャ可能なサウンドウェーブを使用した、ライブマイクキャプチャからのリアルタイムリップシンク。
ローカルのオフラインTTSや、ElevenLabs、OpenAI、Azure、Google Cloudなどを含む外部サービスと互換性があります。
録音済みのオーディオファイル、ストリーミングソース、または任意のカスタムPCMプロバイダーを処理します。
その名前に反して、このプラグインはMetaHuman以外でも十分に機能します。
3つのモデルすべてがMetaHumanをサポートし、RealisticとMood-Enabledでは直接的な顔コントロール出力が可能です。
標準モデルは、柔軟なビセメマッピングを通じてDaz Genesis 8/9、Reallusion CC3/CC4/CC5、Mixamoなどをサポートします。リアリスティックとムード対応も、ARKitを介してこれらをサポートします(例:CC3/CC4/CC5はエクスポート時にARKitへ変換)。
モーフターゲットを持つキャラクターであれば設定可能です。FACS、Apple ARKit、Preston Blair、および3ds Maxの音素システムをサポートします。
標準モデル - カスタムキャラクターの例
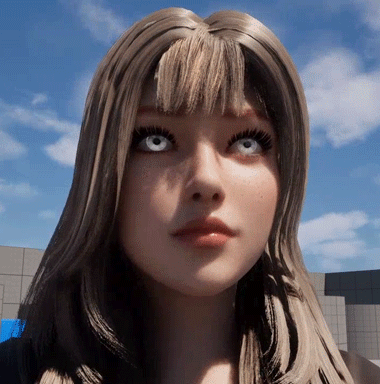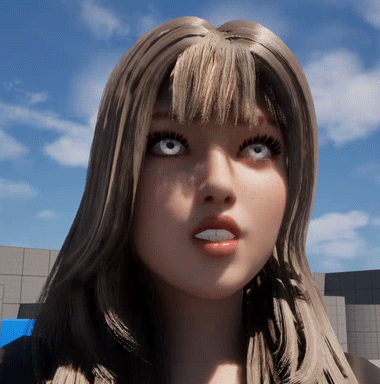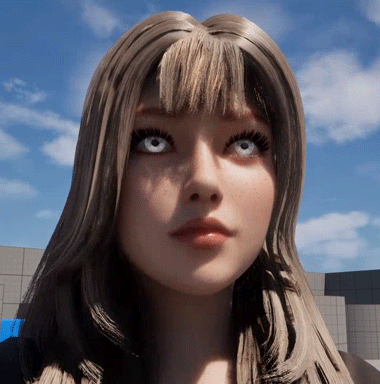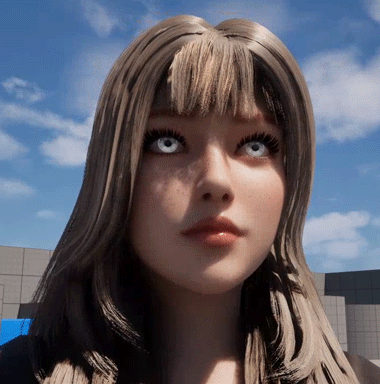
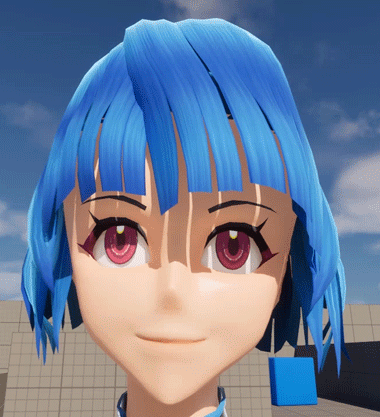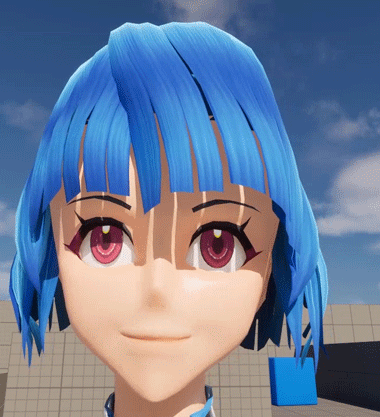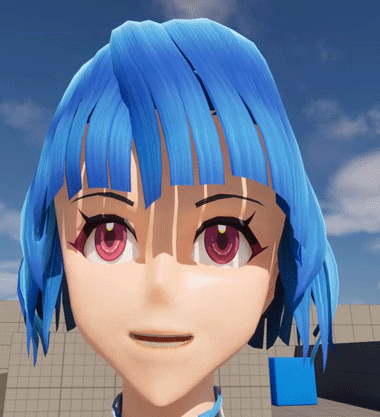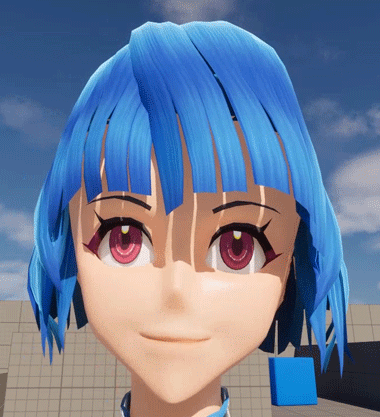
このプラグインは、テキストの文字起こしに依存するのではなく、生の音声音素を直接処理するため、 本質的に言語に依存しません。
英語、スペイン語、フランス語、ドイツ語、日本語、中国語、韓国語、ロシア語、アラビア語、ヒンディー語、 ポルトガル語 - その他あらゆる話し言葉。
プラットフォームサポートとモデル機能のクイックリファレンス。
| 機能 | 標準 | リアリスティック | ムード対応 |
|---|---|---|---|
| アニメーションコントロール | 14ビセメ | 81コントロール | 81 + 12種類のムード |
| MetaHuman | |||
| カスタムキャラクター | ARKit経由 | ARKit経由 | |
| 笑い声検出 | |||
| Windows | |||
| Mac / Linux / iOS | |||
| Android / Quest |
すべてのモデル、オーディオソース、 統合ワークフローを網羅するデモ、チュートリアル、ウォークスルー。すべてのコンテンツはUnreal Engine 5.0から5.8に対応しています。
完全なワークフロー:音声認識、AIチャットボット、TTS、リアルタイム リップシンク。
独自のMetaHumanキャラクターをデモプロジェクトに追加する方法。
ARKitキャラクター向けの完全なAnimation Blueprintセットアップ。オーディオ ファイルと ElevenLabsストリーミングの例付き。
プレイヤーカメラ や任意の 移動ターゲットを追従する自動まばたきと動的な視線。Face Animation Blueprintで設定可能。
Unreal Engine 5上でリアルタイムに動作する音声、リップシンク、顔アニメーション。
マイク、ローカルTTS、 ElevenLabs、 複数言語にわたるRealisticモデルのショーケース。
オーディオファイルを MetaHumanで再生してリアルなリップシンクをセットアップ。オーディオバッファにも 対応。
ストリーミング音声ソースから WebSocket経由でリアルタイムのリップシンクを駆動し、音声はチャンクごとにインポート・処理されます。
感情を認識する高品質なリップシンクを備えたオフラインテキスト読み上げ、 調整可能な強度を持つ12のムード。
ElevenLabsとOpenAIを備えたRealisticモデルで、プレミアム品質の 出力。
Realisticモデルを使用したマイク入力からのリアルタイムリップシンク。
ローカルTTSによる完全オフラインのリップシンク、インターネット接続不要。
Runtime MetaHuman Lip Syncは、より広範なGeorgy Devプラグインスイートと連携して、完全なインタラクティブキャラクターのパイプラインを構築します。
包括的なドキュメントでは、3つのモデルすべてをカバーしています - 初期設定から高度なキャラクター構成、感情アニメーション、カスタムビセームマッピングまで。
すべてのモデル、MetaHuman統合、カスタムキャラクターのためのステップバイステップガイド
開発者サポートを提供する活発なDiscordコミュニティ
ご要望に合わせた統合または機能開発 - [email protected]
UE 5.0 – 5.8 向けに Fab で入手可能。3つのモデル、完全なドキュメント、デモプロジェクトがすべて含まれています。
